
BÀI 4. Bản đồ kiến thức SAA-C03 (Phần 1): Security & Resiliency
Danh sách bài viết trong series Lộ trình chinh phục SAA-C03 đạt 1000/1000
- Bài 0. Hành trình SAA-C03 1000/1000 & Cách mình xây dựng series này
- BÀI 1: Tổng quan SAA-C03 & Thay đổi Mindset để chinh phục 1000/1000
- BÀI 2. Phương pháp ôn tập hiệu quả trong 1 tháng: Cách ghi chú ngắn gọn & Tận dụng AI
- BÀI 3 Thực hành Hands-on & Quản lý chi phí: Học đi đôi với hành
- BÀI 4. Bản đồ kiến thức SAA-C03 (Phần 1): Security & Resiliency
- BÀI 5. Bản đồ kiến thức SAA-C03 (Phần 2): Performance & Cost
- BÀI 6. Chiến thuật luyện đề, Lộ trình 4 tuần & Kinh nghiệm thực chiến phòng thi
Sau khi đã chia sẻ về cách học, ghi chú và hands-on trong những bài trước, từ bài này mình sẽ bắt đầu đi vào những nhóm kiến thức mình tập trung nhiều nhất khi ôn SAA.
Một điều mình nhận ra trong quá trình học là số lượng service nằm trong phạm vi SAA tương đối lớn, nhưng không phải service nào cũng cần học với cùng một độ sâu.
AWS cũng nói rõ danh sách technology và service trong Exam Guide là non-exhaustive và có thể thay đổi. Vì vậy mình vẫn thường xuyên kiểm tra SAA C03 In Scope Services thay vì dựa hoàn toàn vào danh sách của một course hoặc một bài blog.
Mình chủ yếu chia kiến thức theo bốn domain, nhưng không học theo kiểu “Domain 1 xong mới sang Domain 2”, bởi nhiều service có thể xuất hiện trong rất nhiều loại scenario khác nhau.
Mình xem bốn domain giống như bốn góc nhìn đối với một architecture:
Security => Resiliency => Performance => Cost
Trong Bài 4, mình tập trung vào hai domain đầu tiên: Security và Resiliency .
1. Domain 1 – Design Secure Architectures
Đây là domain có tỷ trọng lớn nhất, chiếm 30% scored content.
Nội dung chính xoay quanh secure access, bảo vệ workload/application và lựa chọn các biện pháp bảo vệ dữ liệu phù hợp.
1.1. IAM và Authorization
Đây là một trong những phần mình dành khá nhiều thời gian.
Những concept mình nghĩ nên học chắc bao gồm:
- AWS IAM
- IAM User, Group, Role
- Identity-based Policy
- Resource-based Policy
- Trust Policy
- AWS STS
- Temporary Credentials
- Cross-account access
- Permission Boundary
- IAM Identity Center
- AWS Organizations
- Service Control Policy
Điểm khiến IAM khó theo mình không nằm ở việc định nghĩa từng thành phần.
IAM Role hay IAM Policy nếu đọc riêng lẻ thì khá dễ hiểu. Vấn đề bắt đầu xuất hiện khi một request phải đi qua nhiều lớp authorization cùng lúc.
Ví dụ, một application ở Account A cần đọc một S3 bucket ở Account B.
Lúc này mình phải xác định:
- Principal nằm ở đâu?
- Role nào được assume?
- Trust Policy có cho phép hay chưa?
- Bucket Policy được cấu hình như thế nào?
- Nếu account nằm trong AWS Organizations thì SCP có giới hạn operation đó hay không?
Nếu object lại được mã hóa bằng một customer-managed KMS key thì còn phải để ý thêm KMS Key Policy.
Đây là kiểu scenario mà nếu chỉ cố giữ toàn bộ paragraph trong đầu thì mình khá dễ rối.
Khi luyện, mình thường vẽ Account A và Account B ra giấy, sau đó ghi principal, role và resource rồi nối chúng lại với nhau.
Một paragraph nhiều dòng đôi khi sau khi vẽ chỉ còn vài box và mọi thứ trở nên rõ hơn khá nhiều.
1.2. Network Security
Những phần mình ưu tiên gồm:
- Amazon VPC
- Public và Private Subnet
- Internet Gateway
- NAT Gateway
- Route Table
- Security Group
- Network ACL
- VPC Endpoint
- AWS PrivateLink
- VPC Peering
- AWS Transit Gateway
- AWS Site-to-Site VPN
- AWS Direct Connect
Một cặp cơ bản nhưng rất dễ bị hỏi dưới nhiều hình thức là Security Group và Network ACL.
| Security Group | Network ACL |
|---|---|
| Áp dụng ở resource/ENI level | Áp dụng ở subnet level |
| Stateful | Stateless |
| Chỉ có Allow rule | Có Allow và Deny rule |
Mình không chỉ học thuộc bảng so sánh này mà thường hình dung packet đi từ Internet qua NACL, qua Security Group rồi tới EC2, sau đó quay ngược trở lại.
Khi hiểu được luồng traffic hai chiều, sự khác biệt giữa stateful và stateless trở nên dễ nhớ hơn khá nhiều.
Với networking nói chung, mình nghĩ việc vẽ sơ đồ rất quan trọng.
Ví dụ, khi một scenario có VPC, public subnet, private subnet, NAT Gateway, Internet Gateway và Route Table thì thay vì cố giữ tất cả trong đầu, mình thường vẽ chúng ra giấy rồi đi theo luồng traffic.
Cách này đặc biệt hữu ích khi câu hỏi bắt đầu có thêm nhiều VPC, nhiều account hoặc hybrid connectivity.
Ví dụ với một câu hỏi khá hữu ích là:
“Mình đang cần Internet access, private access tới AWS service, kết nối giữa các VPC hay kết nối on-premises với AWS?”
Từ đó mình thường thu hẹp lựa chọn:
- Outbound Internet từ private subnet => NAT Gateway
- Private access tới AWS service => VPC Endpoint
- Expose một service privately cho VPC khác => PrivateLink
- Kết nối trực tiếp một số VPC => VPC Peering
- Nhiều VPC/network cần mô hình hub-and-spoke => Transit Gateway
- On-premises => AWS qua Internet => Site-to-Site VPN
- Dedicated connectivity => Direct Connect
Đây chỉ là mental map ban đầu; lựa chọn cuối cùng vẫn phải dựa vào requirement cụ thể.
1.3. Encryption và Data Protection
Một nhóm kiến thức khác mình chú ý nhiều là encryption và bảo vệ dữ liệu.
Những service/concept chính gồm:
- AWS KMS
- AWS Certifcate Manager
- AWS Secrets Manager
- Systems Manager Parameter Store
- Encryption at rest
- Encryption in transit
- S3 security
- EBS encryption
- RDS encryption
- AWS WAF
- AWS Shield
- AWS CloudTrail
Với nhóm này mình không nhất thiết phải học thuộc mọi API hoặc mọi configuration chi tiết.
Điều mình tập trung nhiều hơn là hiểu: Mình đang cần bảo vệ cái gì và đang bảo vệ ở layer nào?
Ví dụ, nếu requirement nói database password cần được lưu an toàn và rotate tự động, mình sẽ nghĩ đến Secrets Manager .
Nếu vấn đề là mã hóa data at rest thì KMS hoặc encryption option của từng service lại trở nên quan trọng hơn.
AWS Nếu requirement nói tới HTTPS hoặc certificate management thì mình sẽ nghĩ tới . Certificate Manager
Một ví dụ cụ thể với Secrets Manager vs Systems Manager Parameter Store .
Mental model mình dùng như sau:
Secrets Manager => secret + built-in rotation
Parameter Store => configuration/parameter, có thể lưu SecureString
Hai service có một số use case giao nhau nên mình cần xác định rõ nếu scenario nhấn mạnh credential hoặc password cần automatic rotation, Secrets Manager là phương án phù hợp hơn.
Theo mình, khi học theo cách này, những service security bớt trở thành một danh sách rời rạc và bắt đầu gắn với từng loại requirement cụ thể hơn.
2. Domain 2 – Design Resilient Architectures
Đây là domain mình khá thích vì nó thể hiện rõ tư duy của một Solutions Architect:
Làm sao để hệ thống vẫn hoạt động khi component gặp lỗi, làm sao để scale và làm sao để các thành phần không phụ thuộc quá chặt vào nhau?
Một nội dung mình cần phân biệt rõ High Availability không hoàn toàn giống Disaster Recovery.
Với High Availability, mình thường nghĩ tới việc hệ thống tiếp tục phục vụ khi một component hoặc một Availability Zone gặp lỗi.
Với Disaster Recovery, câu hỏi thường rộng hơn: nếu một sự cố lớn xảy ra thì mất bao nhiêu dữ liệu là chấp nhận được và mất bao lâu để hệ thống phục hồi.
Vì vậy mình thường liên tưởng:
HA => Multi-AZ / redundancy / failover
DR => RTO / RPO / recovery strategy
Hai khái niệm có liên quan nhưng không được nhầm lẫn.
2.1. High Availability và Fault Tolerance
Những concept mình tập trung gồm:
- Region / Availability Zone
- Multi-AZ
- Multi-Region
- Elastic Load Balancing
- EC2 Auto Scaling
- Amazon Route 53
- Health Check
- Stateless Architecture
Với High Availability, mục tiêu là giảm downtime và giúp hệ thống nhanh chóng failover hoặc phục hồi khi một component gặp sự cố.
Một architecture web cơ bản mình thường hình dung là:
Route 53 => ALB => Auto Scaling Group trên nhiều AZ => Database có HA
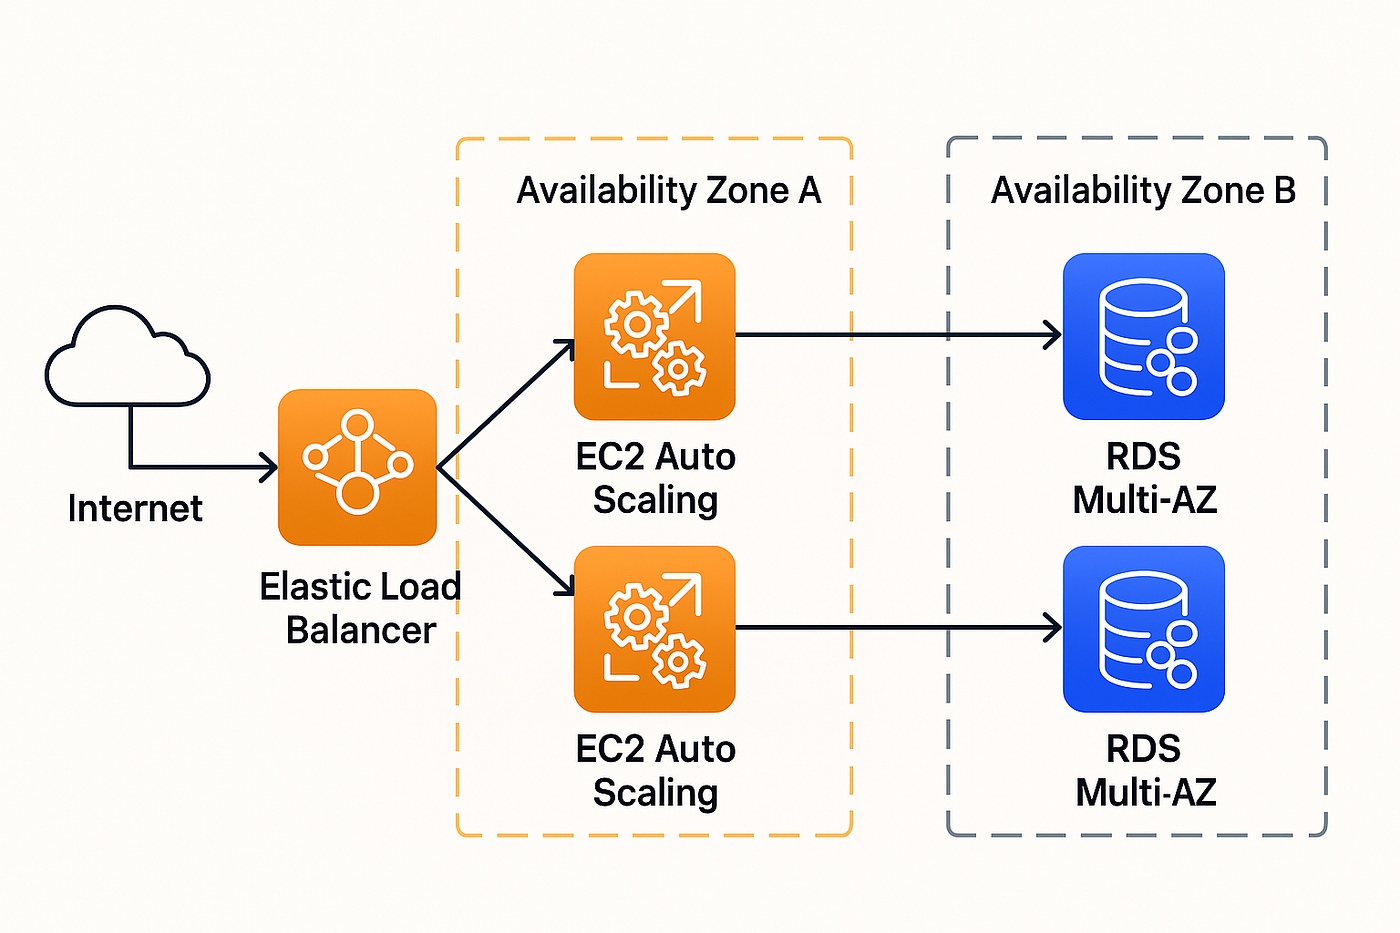
Khi câu hỏi nhấn mạnh high availability , điều đầu tiên mình thường kiểm tra là architecture có component nào đang trở thành single point of failure hay không.
Ví dụ, phía trước có ALB, Auto Scaling Group trải trên hai Availability Zone nhưng database lại chỉ chạy một instance duy nhất trong một AZ thì hệ thống vẫn chưa thật sự resilient.
Mình thấy đây là một cách khá hữu ích để đọc những câu HA: thay vì ngay lập tức tìm một service “xịn hơn”, mình kiểm tra xem architecture hiện tại đang có điểm yếu ở đâu trước.
Với Fault Tolerance thì đi xa hơn một bước: hệ thống được thiết kế với đủ redundancy để vẫn có thể tiếp tục hoạt động ngay cả khi một component bị lỗi, với rất ít hoặc gần như không có gián đoạn.
Mental model mình thường dùng là:
High Availability => giảm downtime / failover nhanh
Fault Tolerance => tiếp tục hoạt động khi có lỗi
Đổi lại, Fault Tolerance thường cần nhiều redundancy hơn nên architecture cũng có thể phức tạp và tốn chi phí hơn. Vì vậy lựa chọn cuối cùng vẫn phải dựa vào requirement cụ thể của workload.
2.2. Decoupling
Những service mình nghĩ cần quen thuộc gồm:
- Amazon SQS
- Amazon SNS
- Amazon EventBridge
- AWS Lambda
Một pattern đơn giản nhưng xuất hiện rất nhiều là
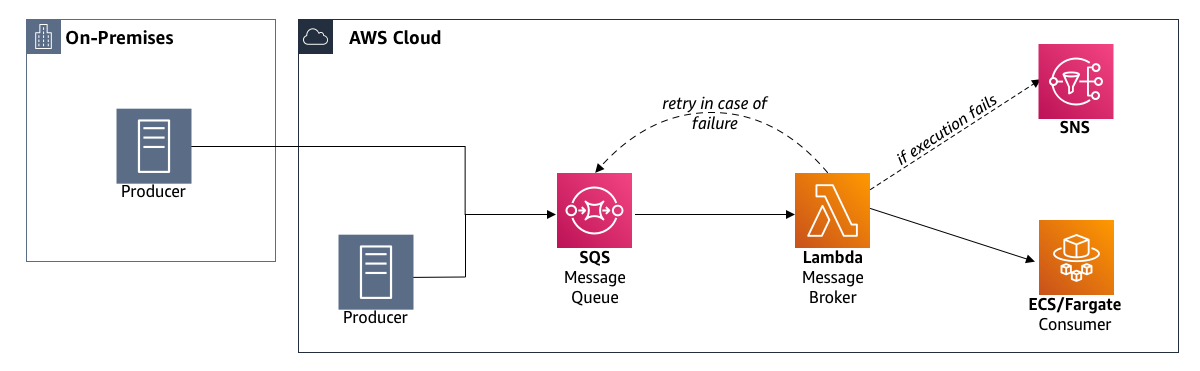
Giả sử application nhận một lượng request rất lớn nhưng worker phía sau xử lý chậm hơn.
Nếu producer phải chờ consumer xử lý xong từng request thì hai thành phần sẽ phụ thuộc khá chặt vào nhau.
Khi đặt SQS ở giữa, queue có thể đóng vai trò như một buffer: Producer => SQS => Consumer
Producer vẫn tiếp tục gửi message, còn consumer xử lý theo tốc độ riêng và có thể scale độc lập.
Mình nghĩ chỉ cần hiểu rõ bản chất này thì rất nhiều scenario liên quan đến SQS sẽ trở nên dễ xử lý hơn.
Tương tự:
- Nếu một event cần gửi tới nhiều consumer khác nhau thì SNS fan-out là một pattern nên nhớ.
- Với EventBridge, mình thường liên tưởng tới event routing dựa trên rule/pattern giữa nhiều source và target.
Mình có thể nắm use case như sau:
- SQS => queue / buffer / decouple
- SNS => pub/sub / fan-out
- EventBridge => event routing theo rule/pattern
Điểm mình tập trung không phải chỉ là định nghĩa từng service, mà là hiểu khi nào architecture cần decouple và kiểu giao tiếp nào phù hợp nhất.
2.3. Database Resiliency
Một cặp rất quan trọng mình cần phân biệt là: RDS Multi-AZ & Read Replica
Mental model mình sử dụng khá đơn giản:
- Multi-AZ => Availability / Failover
- Read Replica => Read Scalability
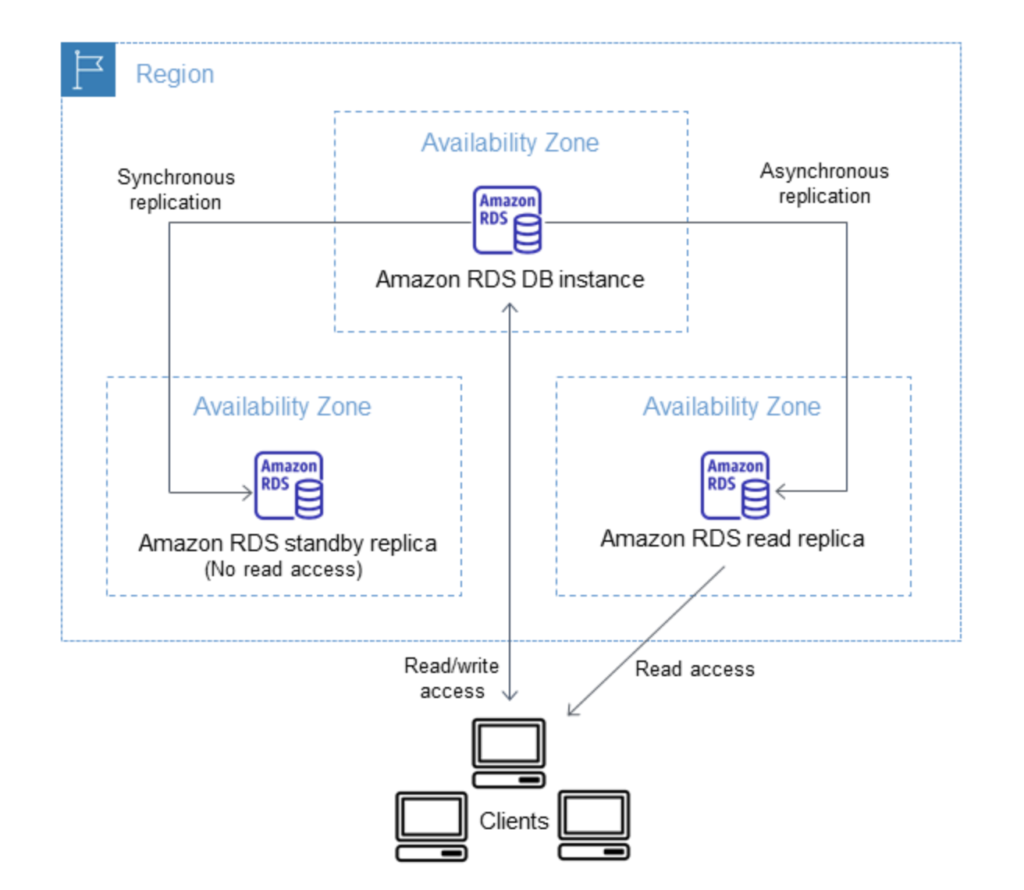
Nếu requirement nói primary database cần tự động failover khi gặp sự cố thì mình ưu tiên nghĩ tới Multi-AZ.
Nếu hệ thống bị quá tải vì lượng read query lớn thì Read Replica hoặc caching lại đáng xem xét hơn.
Mình thấy đây là một ví dụ rất điển hình cho cách SAA đặt câu hỏi:
Cả hai solution đều có thêm database instance, nhưng chỉ cần requirement thay đổi vài từ thì lựa chọn phù hợp cũng thay đổi.
Ngoài ra, mình cũng dành thời gian cho:
- Amazon Aurora
- Aurora Replica
- Amazon DynamoDB Global Tables
- S3 Replication
- Backup và Snapshot
Điểm mình tập trung ở nhóm này là không chỉ nhìn vào việc hệ thống có thêm một bản sao dữ liệu, mà phải xác định bản sao đó được tạo ra để làm gì: tăng availability, scale read, replication sang nơi khác hay phục vụ backup/recovery.
2.4. Disaster Recovery
Một phần khác mình nghĩ cần nắm chắc là bốn Disaster Recovery strategy:
Backup & Restore => Pilot Light => Warm Standby => Multi-Site Active/Active
Mình không học bốn strategy này như bốn định nghĩa riêng biệt mà thường đặt chúng trên hai trục:
Recovery nhanh dần và Chi phí tăng dần
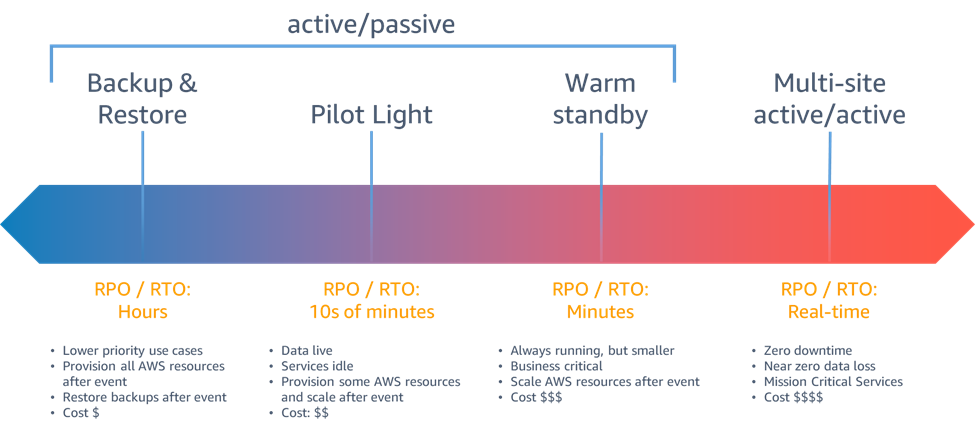
Ở một đầu, Backup & Restore thường có chi phí thấp hơn nhưng thời gian recovery lâu hơn.
Ở đầu còn lại, Multi-Site Active/Active cho khả năng recovery rất nhanh nhưng phải đánh đổi bằng complexity và chi phí cao hơn.
Ở giữa là Pilot Light và Warm Standby, với mức độ resource được duy trì sẵn ở disaster recovery environment tăng dần.
Vì vậy, khi câu hỏi đưa ra các constraint như:
- RTO
- RPO
- Cost
- Recovery speed
Mình thường cố tìm điểm cân bằng phù hợp thay vì mặc định chọn strategy mạnh nhất.
Theo mình, đây cũng là một tư duy khá quan trọng trong SAA: architecture tốt không nhất thiết là architecture có nhiều resource nhất, mà là architecture đáp ứng đúng requirement với mức trade-off phù hợp.
Kết luận
Với hai domain Security và Resiliency, mình không cố học mọi service theo cùng một độ sâu mà chủ yếu tập trung vào những concept thường xuyên xuất hiện trong architecture và các nhóm dễ gây nhầm.
Phần Security, mình chú ý nhiều tới authorization, network access và data protection. Với Resiliency, mình tập trung vào high availability, decoupling, database resiliency và disaster recovery.
Ở Bài 5, mình sẽ tiếp tục với hai domain còn lại: High-Performing Architectures và Cost-Optimized Architectures, đồng thời đi sâu hơn vào các nhóm service về storage, compute, database, networking và cost optimization.