
BÀI 5. Bản đồ kiến thức SAA-C03 (Phần 2): Performance & Cost
Danh sách bài viết trong series Lộ trình chinh phục SAA-C03 đạt 1000/1000
- Bài 0. Hành trình SAA-C03 1000/1000 & Cách mình xây dựng series này
- BÀI 1: Tổng quan SAA-C03 & Thay đổi Mindset để chinh phục 1000/1000
- BÀI 2. Phương pháp ôn tập hiệu quả trong 1 tháng: Cách ghi chú ngắn gọn & Tận dụng AI
- BÀI 3 Thực hành Hands-on & Quản lý chi phí: Học đi đôi với hành
- BÀI 4. Bản đồ kiến thức SAA-C03 (Phần 1): Security & Resiliency
- BÀI 5. Bản đồ kiến thức SAA-C03 (Phần 2): Performance & Cost
- BÀI 6. Chiến thuật luyện đề, Lộ trình 4 tuần & Kinh nghiệm thực chiến phòng thi
Ở Bài 4, mình đã đi qua hai góc nhìn đầu tiên của một architecture trong SAA: Security và Resiliency .
Trong bài này, mình tiếp tục với hai domain còn lại là High-Performing Architectures và Cost-Optimized Architectures. Đây là hai phần mình thấy có khá nhiều service dễ nhầm, đặc biệt ở storage, compute, database và networking.
1. Domain 3 – Design High-Performing Architectures
Domain này khá rộng, bao gồm storage, compute, database, networking và data processing.
Đây cũng là nơi có khá nhiều service dễ nhầm nên mình dành tương đối nhiều thời gian cho comparison.
1.1. Storage
Ba nhóm đầu tiên mình luôn phải phân biệt thật chắc:
- Amazon S3 => Object Storage
- Amazon EBS => Block Storage
- Amazon EFS => Shared File Storage
Sau đó mình mở rộng sang:
- S3 Storage Classes
- EBS volume types
- Snapshot
- Amazon FSx
- AWS DataSync
- AWS Storage Gateway
Mình thấy cách học hiệu quả nhất đó là nhìn vào workload.
Với storage, mình thường tự hỏi ba câu trước:
- Dữ liệu cần được truy cập theo kiểu Object, Block hay File?
- Một resource hay nhiều resource cần truy cập?
- Access pattern và retrieval requirement như thế nào?
Chỉ ba câu này thường đã giúp mình loại được khá nhiều lựa chọn. Sau đó mình mới đi sâu hơn vào availability, throughput, storage class hoặc cost.
Ví dụ:
- Một EC2 instance cần disk để cài OS hoặc database => mình nghĩ tới EBS.
- Nhiều Linux EC2 instance ở nhiều Availability Zone cần truy cập chung một filesystem => EFS phù hợp hơn.
- Application cần lưu một lượng lớn file, image, backup hoặc object và không cần mount như một filesystem truyền thống => S3 là lựa chọn tự nhiên hơn.
Với S3 Storage Classes, mình cũng không nên nhớ đơn giản theo kiểu: “Glacier = rẻ.”
Mình thường nhìn vào ba yếu tố:
- Access frequency
- Retrieval time
- Durability/availability requirement
Ví dụ, dữ liệu archive nhưng vẫn cần truy xuất gần như ngay lập tức sẽ phù hợp với S3 Glacier Instant Retrieval hơn một workload có thể chờ nhiều giờ để restore. Vì vậy mình thường dùng bảng sau để phân biệt nhanh các lớp Glacier theo use case và retrieval time.
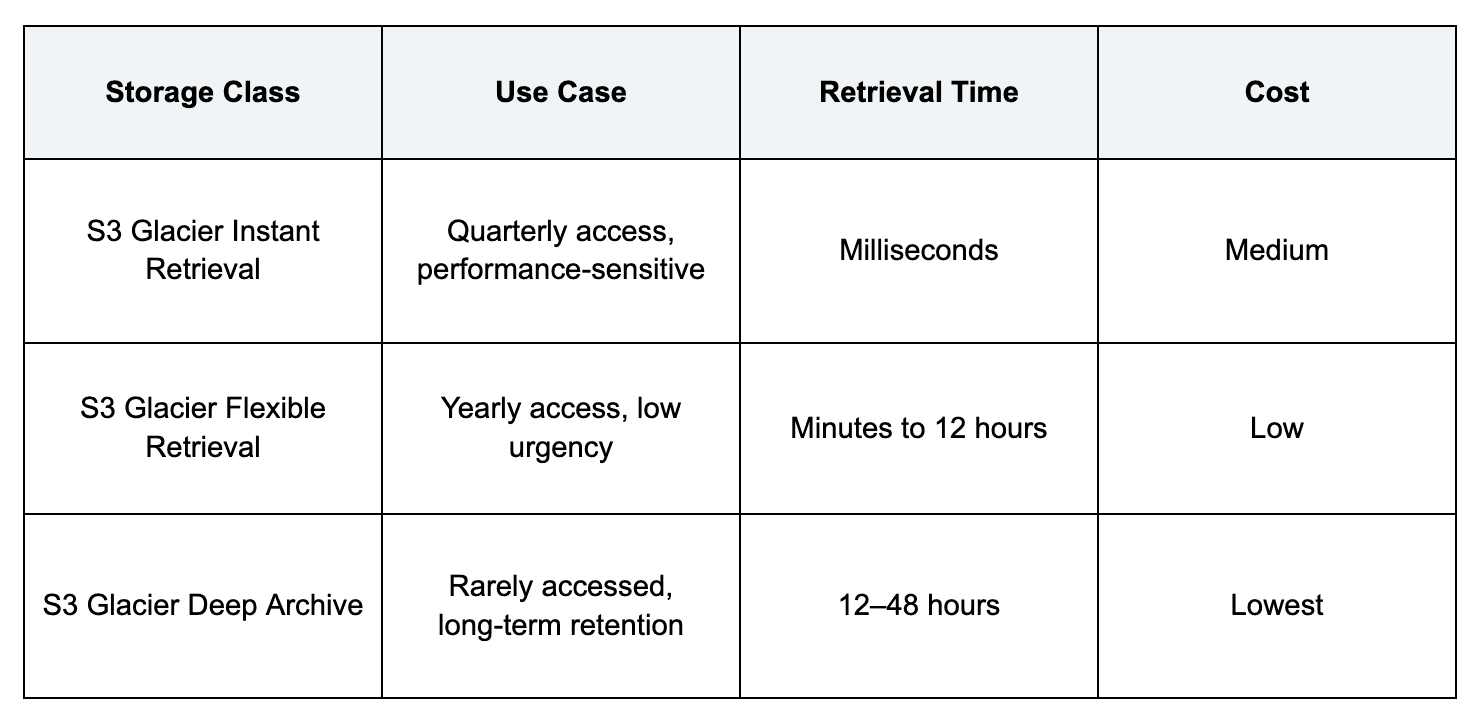
Từ những requirement này, việc chọn Storage Class phù hợp trở nên tự nhiên hơn khá nhiều so với việc cố nhớ một bảng feature dài.
1.2. Compute
Những service chính mình học gồm:
- Amazon EC2
- AWS Lambda
- Amazon ECS
- Amazon EKS
- AWS Fargate
Một điều mình cần tránh là hình thành shortcut kiểu:
“Minimum operational overhead => Lambda.”
Serverless thường giúp giảm operational overhead thật, nhưng solution vẫn phải phù hợp với workload.
Nếu application xử lý event ngắn, traffic thất thường và không cần quản lý server thì Lambda khá tự nhiên.
Nhưng nếu workload chạy lâu, cần control OS hoặc có dependency đặc biệt thì EC2 hoặc container có thể phù hợp hơn.
Vì vậy, mình thường không bắt đầu từ câu hỏi:
“Service nào managed hơn?”
mà từ:
“Workload này thực sự cần môi trường thực thi như thế nào?”
1.3. Database
Các service mình nghĩ cần phân biệt khá chắc gồm:
- Amazon RDS
- Amazon Aurora
- Amazon DynamoDB
- Amazon ElastiCache
- DynamoDB Accelerator – DAX
- RDS Proxy
- Read Replica / Multi-AZ
Một mental model khá đơn giản mà mình sử dụng là:
Relational + SQL + transaction => RDS / Aurora
Key-value + scale lớn + low latency => DynamoDB
General database caching => ElastiCache
DynamoDB-specific cache => DAX
Tất nhiên, mình không xem đây là công thức tuyệt đối.
Một vài keyword chỉ giúp mình thu hẹp phạm vi lựa chọn ban đầu, sau đó mình vẫn phải đọc kỹ requirement để xác định solution phù hợp.
Ví dụ, nếu chỉ thấy chữ “low latency” trong đề thì chưa đủ để chọn DynamoDB hay DAX. Mình vẫn cần biết application đang sử dụng database gì, kiểu access pattern ra sao và vấn đề thực sự cần giải quyết nằm ở đâu.
Một nội dung khá hay là khi application có nhiều connection tới RDS/Aurora, chẳng hạn workload serverless với Lambda có thể tạo ra lượng connection lớn, thì mình sẽ nghĩ đến RDS Proxy.
Mental model của mình là:
RDS Proxy => manage/pool database connections
Vì vậy:
Performance do read nhiều => Read Replica / Cache
Connection management => RDS Proxy
1.4. Networking và Content Delivery
Những phần mình chú ý gồm:
- ALB / NLB
- Route 53 routing policies
- Amazon CloudFront
- AWS Global Accelerator
- VPN
- Direct Connect
- Transit Gateway
- PrivateLink
Một chỗ mình từng khá hay nhầm là cả CloudFront và Global Accelerator đều sử dụng AWS global infrastructure nên nhìn qua use case có vẻ khá giống nhau. Sau đó mình thấy dễ phân biệt hơn nếu để ý protocol, loại application và service cần tích hợp.
CloudFront phù hợp hơn với các workload HTTP/HTTPS liên quan đến content delivery, caching và có thể tích hợp trực tiếp với AWS WAF để bảo vệ web application.
Trong khi đó, Global Accelerator hỗ trợ TCP/UDP, cung cấp các static Anycast IP làm fixed entry point và tối ưu network path qua AWS global network, nên mình thường cân nhắc nó với những workload như gaming, VoIP hoặc application cần kết nối TCP/UDP toàn cầu.
Vì vậy, ngoài việc nhớ:
CloudFront => Content / Caching
Global Accelerator => Network Path / Global Endpoint
Mình còn để ý thêm requirement kiểu WAF / HTTP content hay TCP/ UDP / Static IP để phân biệt hai service nhanh hơn.
1.5. Data và Migration
Ở nhóm này mình không đào quá sâu vào configuration, nhưng vẫn cần nắm use case chính của:
- Amazon Kinesis Data Streams
- AWS Glue
- Amazon Athena
- Amazon EMR
- Amazon Redshift
- AWS Database Migration Service
Mục tiêu của mình chủ yếu là khi scenario xuất hiện những requirement như streaming, ETL, query dữ liệu trên S3, big data processing, data warehouse hay database migration
thì mình biết nên nghĩ tới nhóm service nào trước, thay vì học sâu configuration của tất cả.
Ví dụ:
- Nếu dữ liệu đang nằm trên S3 và requirement chỉ cần dùng SQL để query trực tiếp mà không muốn dựng thêm database hay cluster, mình sẽ nghĩ tới Athena.
- Nếu cần ETL, transform dữ liệu hoặc quản lý Data Catalog, mình sẽ cân nhắc AWS Glue.
- Nếu workload cần xử lý streaming data gần real-time, Kinesis Data Streams sẽ là một service mình nghĩ tới sớm.
- Nếu bài toán là big data processing với những framework như Spark hoặc Hadoop, mình sẽ nghĩ tới Amazon EMR.
- Nếu requirement tập trung vào data warehouse và analytics trên lượng dữ liệu lớn, Amazon Redshift sẽ phù hợp hơn.
- Nếu cần migrate database từ on-premises hoặc giữa các database engine với downtime thấp, mình sẽ nghĩ tới AWS DMS
Mình không xem những association này là công thức tuyệt đối, nhưng chúng giúp mình xác định nhanh service family phù hợp với workload, sau đó mới đọc tiếp các requirement chi tiết để chọn solution.
2. Domain 4 – Design Cost-Optimized Architectures
Domain này chiếm 20% scored content, nhưng cost optimization thực tế có thể xuất hiện xuyên suốt kỳ thi vì khá nhiều scenario yêu cầu: MOST cost-effective
Một điều mình rút ra là cost optimization không có nghĩa đơn giản là:
“Chọn service rẻ nhất.”
Solution vẫn phải đáp ứng đúng requirement về availability, performance, security và operational needs trước khi mình tối ưu chi phí.
2.1. Compute Cost
Ở compute, mình tập trung vào:
- On-Demand
- Spot Instances
- Reserved Instances
- Savings Plans
Điều mình quan tâm không phải chỉ là nhớ option nào rẻ hơn bao nhiêu phần trăm, mà là hiểu workload nào phù hợp với pricing model đó.
Ví dụ, nếu workload là batch job có thể retry khi bị interrupt thì Spot rất đáng cân nhắc.
Nhưng nếu một database production quan trọng đang chạy trên đúng một instance thì việc chọn Spot chỉ vì “rẻ” rõ ràng không phải một architecture phù hợp.
Một cặp mình từng khá dễ nhầm là Reserved Instances và Savings Plans, vì cả hai đều có thể yêu cầu commitment 1 hoặc 3 năm để đổi lấy mức giá thấp hơn so với OnDemand.
Cách mình phân biệt đơn giản là:
Reserved Instances => commitment gắn nhiều hơn với EC2 configuration
Savings Plans => commitment theo mức sử dụng tính bằng USD/giờ
Savings Plans thường linh hoạt hơn. Đặc biệt với Compute Savings Plans, workload có thể thay đổi instance family, size, Region hoặc thậm chí chuyển giữa EC2, Fargate và Lambda mà vẫn có thể hưởng mức giá Savings Plans phù hợp.
Nếu workload EC2 tương đối ổn định và predictable thì Reserved Instances có thể là một lựa chọn đáng cân nhắc. Trường hợp muốn commitment dài hạn nhưng cần linh hoạt hơn khi architecture hoặc compute usage thay đổi thì mình sẽ nghĩ tới Savings Plans.
Vì vậy, khi thấy cost requirement, mình thường xem thêm:
- Workload có ổn định không?
- Có thể bị interrupt không?
- Chạy dài hạn hay ngắn hạn?
- Có predictable usage hay không?
- Có cần linh hoạt thay đổi compute configuration trong tương lai không?
Sau đó mới cân nhắc pricing option phù hợp.
2.2. Storage Cost
Với S3 Storage Classes, mình cần hiểu use case của:
- Standard
- Intelligent-Tiering
- Standard-IA
- One Zone-IA
- Glacier Instant Retrieval
- Glacier Flexible Retrieval
- Glacier Deep Archive
Thay vì học thuộc giá của từng class, mình thường nhìn vào access pattern.
Ví dụ, một scenario có thể nói dữ liệu:
- cần lưu 7 năm vì compliance;
- gần như không truy cập;
- có thể chờ nhiều giờ khi restore.
Trong trường hợp đó, requirement gần như tự dẫn mình về nhóm archival storage, chẳng hạn S3 Glacier Deep Archive, thay vì phải nhớ chính xác bảng giá.
Ngược lại, nếu access pattern thay đổi và khó dự đoán thì S3 Intelligent-Tiering sẽ là một lựa chọn đáng cân nhắc hơn.
Mình thường tham khảo bảng so sánh các S3 Storage Classes để hình dung nhanh mối quan hệ giữa access pattern, retrieval time và chi phí lưu trữ.
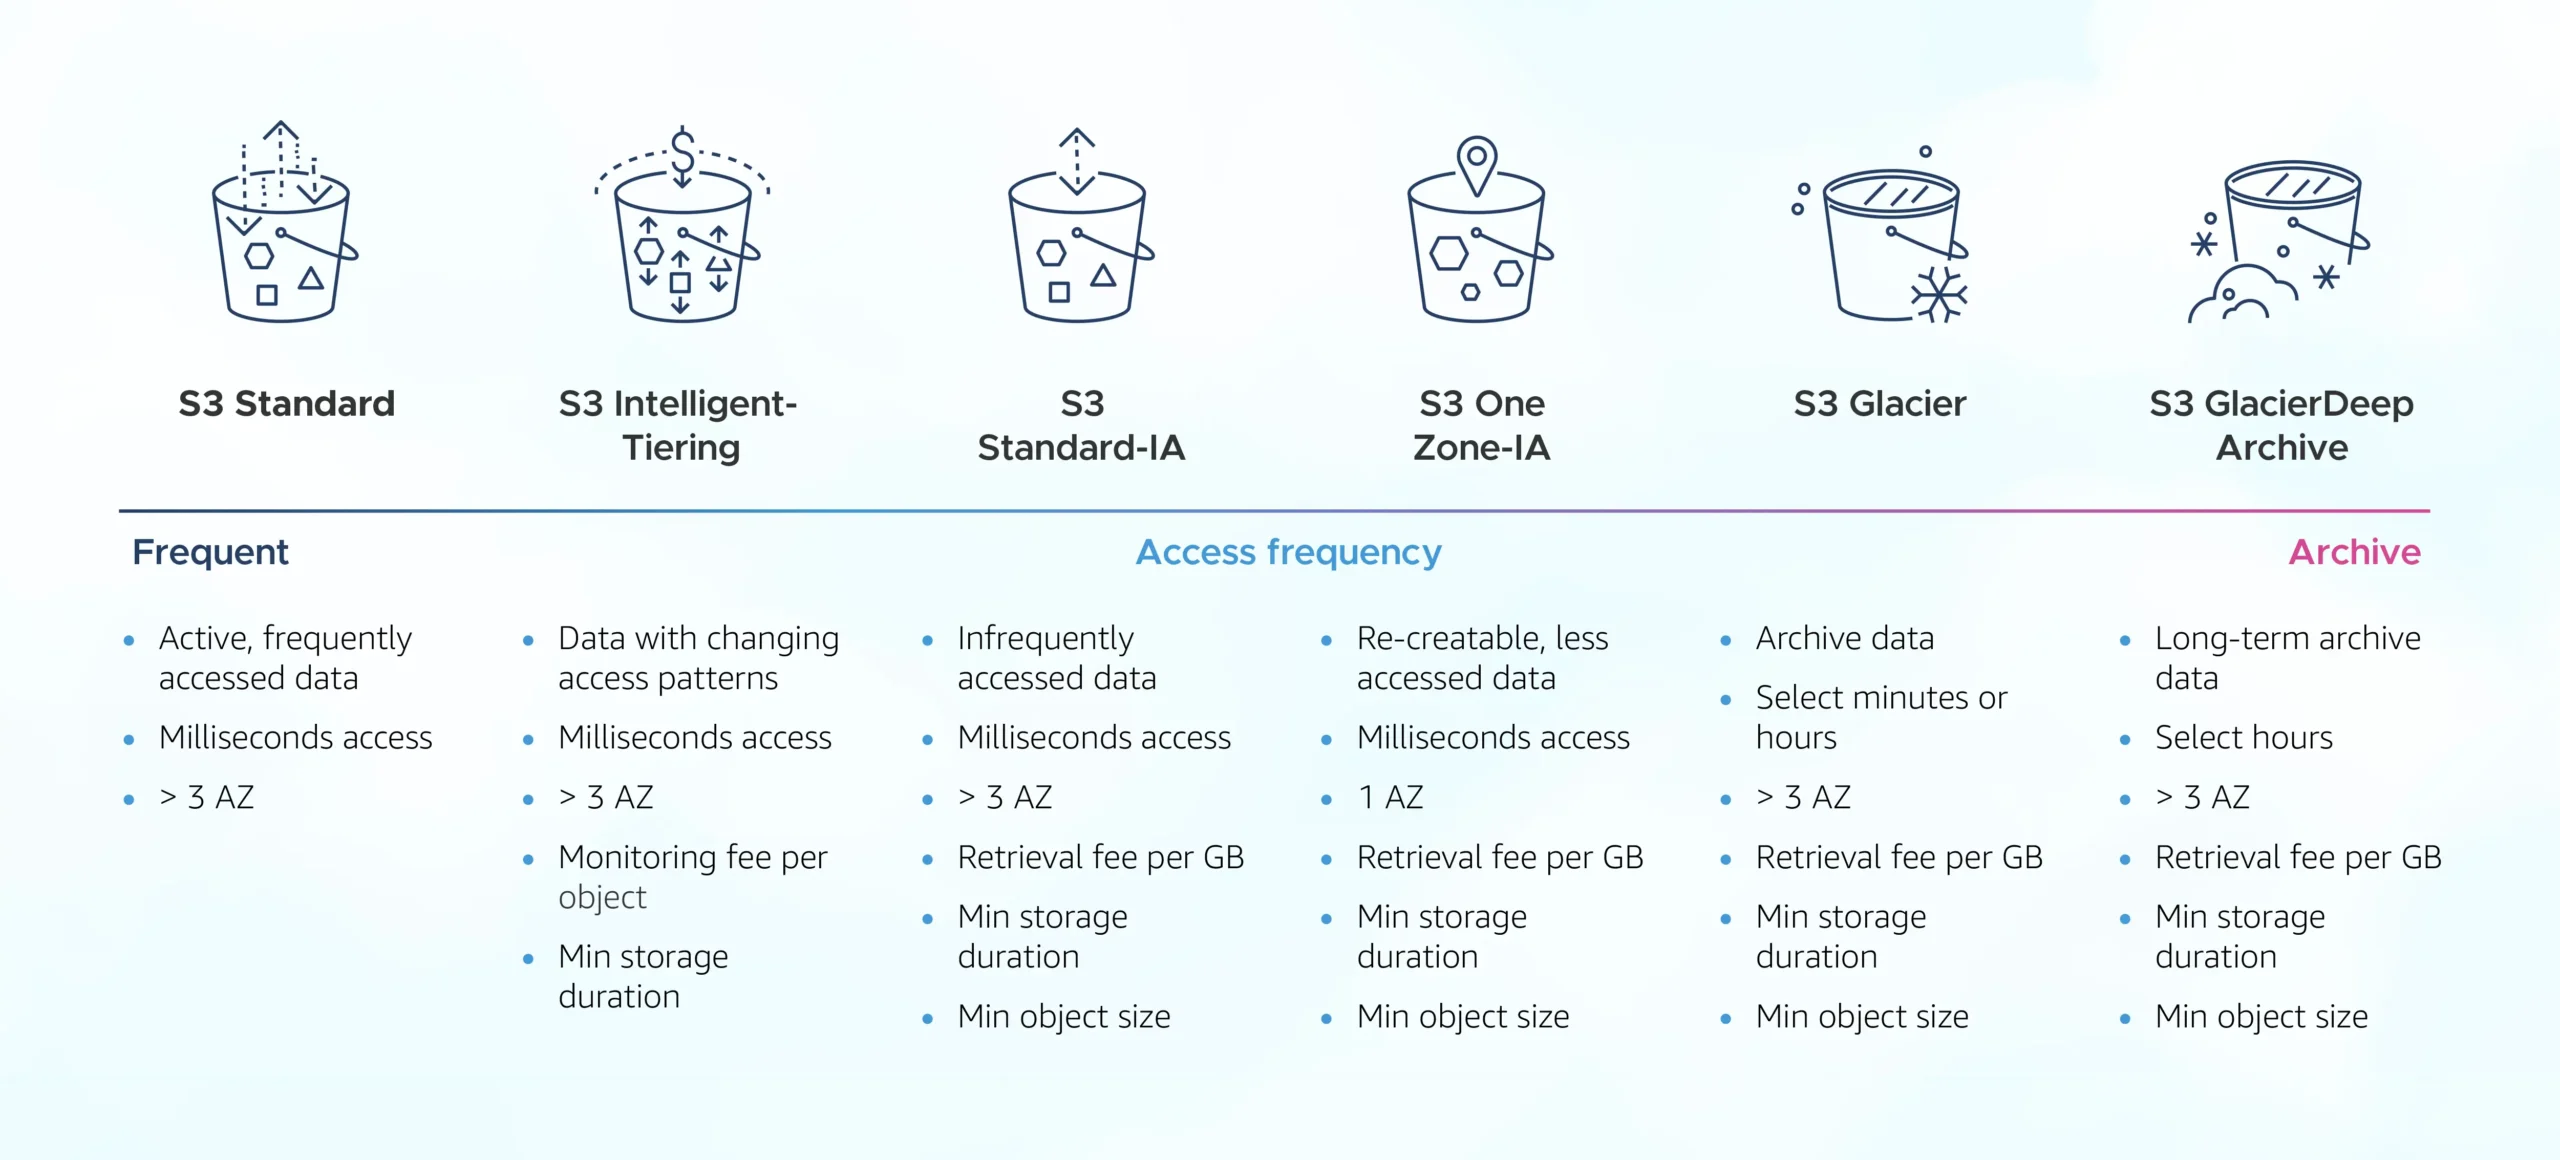
Lưu ý: Hình trên mang tính minh họa và có thể đã cũ ở một số chi tiết. Vì S3 Storage Classes có thể được AWS cập nhật theo thời gian, mình khuyến khích mọi người tham khảo thêm AWS Documentation chính thức để kiểm tra thông tin mới nhất.
2.3. Network Cost
Đây là một phần mình hay dễ bỏ qua.
Các yếu tố như:
- Cross-AZ traffic
- Cross-Region traffic
- NAT Gateway processing
- Internet data transfer
Đều có thể ảnh hưởng tới chi phí của architecture.
Ví dụ, một private EC2 cần thường xuyên truy cập dữ liệu trên Amazon S3. Một cách là để traffic đi từ private subnet qua NAT Gateway, sau đó truy cập public endpoint của S3.
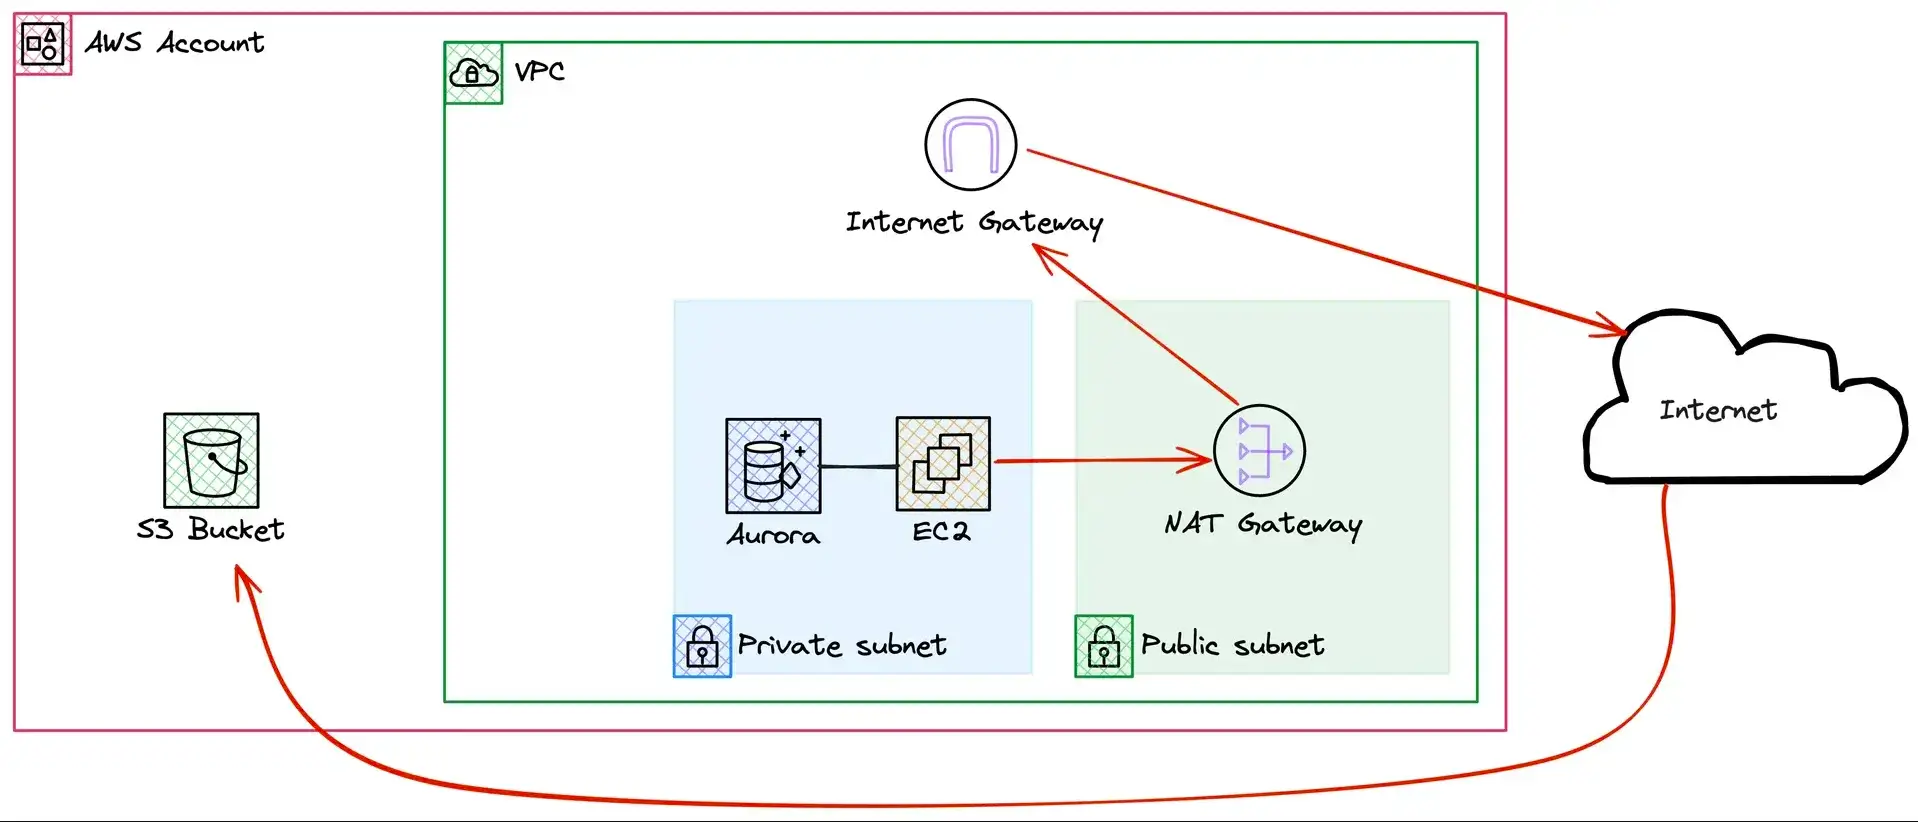
Cách này technically vẫn hoạt động, nhưng traffic tới S3 phải đi qua NAT Gateway và có thể phát sinh thêm NAT Gateway processing cost.
Nếu workload chủ yếu cần truy cập S3 từ bên trong VPC, mình có thể sử dụng S3 Gateway Endpoint để tạo một private route tới S3 mà không cần đưa traffic đó qua NAT Gateway.
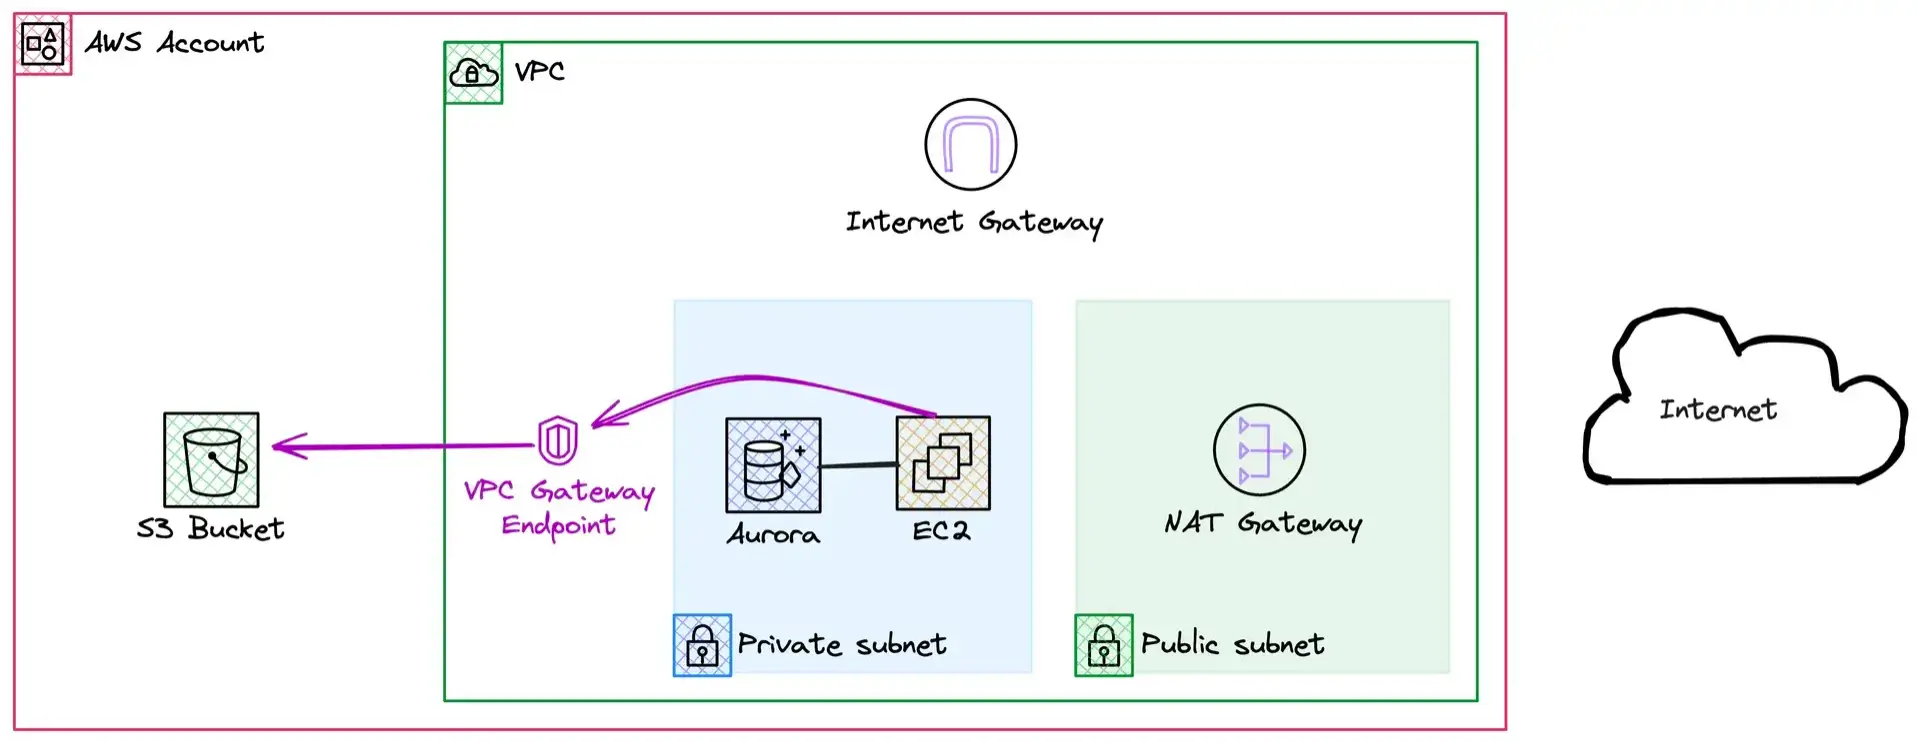
Vì vậy, khi một scenario nhấn mạnh cost optimization và private connectivity tới S3, S3 Gateway Endpoint là một lựa chọn mình sẽ cân nhắc trước. Đây cũng là ví dụ khá rõ cho việc tối ưu chi phí không chỉ nằm ở EC2 pricing hay S3 Storage Classes, mà đôi khi nằm ngay trong cách mình thiết kế network path.
3. Những service mình thấy dễ nhầm
Ngoài việc học theo từng domain, trong suốt quá trình ôn tập mình tự tạo khá nhiều bảng A vs B để review nhanh.
Một số comparison thuộc Security hoặc Resiliency mình đã nhắc ở Bài 4, nhưng mình vẫn gom chúng lại ở đây như một bảng tổng hợp vì đây là một trong những tài liệu mình xem lại khá thường xuyên trước khi luyện đề.
| So sánh | Điểm mình dùng để phân biệt |
|---|---|
| Security Group vs NACL | Stateful vs Stateless |
| IAM User vs IAM Role | Long-term identity vs Role/temporary access |
| Identity Policy vs Resource Policy | Gắn với identity vs resource |
| Secrets Manager vs Parameter Store | Secret/rotation vs config/parameter |
| ALB vs NLB | Layer 7 vs Layer 4 |
| SQS vs SNS | Queue vs Pub/Sub |
| SNS vs EventBridge | Fan-out vs event routing |
| RDS Multi-AZ vs Read Replica | HA vs Read Scaling |
| RDS/Aurora vs DynamoDB | Relational vs NoSQL |
| ElastiCache vs DAX | General caching vs DynamoDB cache |
| EBS vs EFS vs S3 | Block vs File vs Object |
| CloudFront vs Global Accelerator | CDN/cache vs network acceleration |
| VPC Peering vs Transit Gateway | Point-to-point vs hub-and-spoke |
| VPN vs Direct Connect | Internet tunnel vs dedicated connection |
| NAT Gateway vs VPC Endpoint | Internet egress vs private service access |
| DataSync vs Storage Gateway | Data transfer vs hybrid storage integration |
| Lambda vs Fargate/EC2 | Function model vs container/server workload |
Mình nghĩ tự xây những bảng như thế này có giá trị hơn việc cố học thuộc hàng trăm feature riêng lẻ.
Một khi mình hiểu được hai service khác nhau ở điểm nào, khi gặp distractor trong đề mình thường loại đáp án nhanh hơn khá nhiều.
Quan trọng hơn, mình không xem cột bên phải là một bộ keyword để chọn đáp án ngay lập tức. Nó chỉ là mental shortcut để mình nhớ sự khác biệt chính, còn lựa chọn cuối cùng vẫn phải quay lại requirement của scenario.
Kết luận
Với Performance và Cost, cách mình học chủ yếu vẫn xoay quanh workload và requirement. Thay vì nhớ service nào “nhanh nhất” hay “rẻ nhất”, mình tập trung vào việc hiểu loại storage, compute, database hoặc network nào phù hợp với bài toán trước, sau đó mới xét tới performance và cost.
Các bảng comparison cũng giúp mình xử lý những service dễ nhầm nhanh hơn, nhưng vẫn chỉ là điểm bắt đầu cho reasoning chứ không phải công thức chọn đáp án.
Ở Bài 6, mình sẽ chuyển sang giai đoạn cuối của hành trình: tài liệu luyện đề, cách mình review câu sai, cách đọc scenario, quản lý thời gian, roadmap 4 tuần và trải nghiệm thực tế trong ngày thi.