
Tại sao tư duy tìm lỗi gốc (RCA) có thể sập hệ thống trong sự cố Production
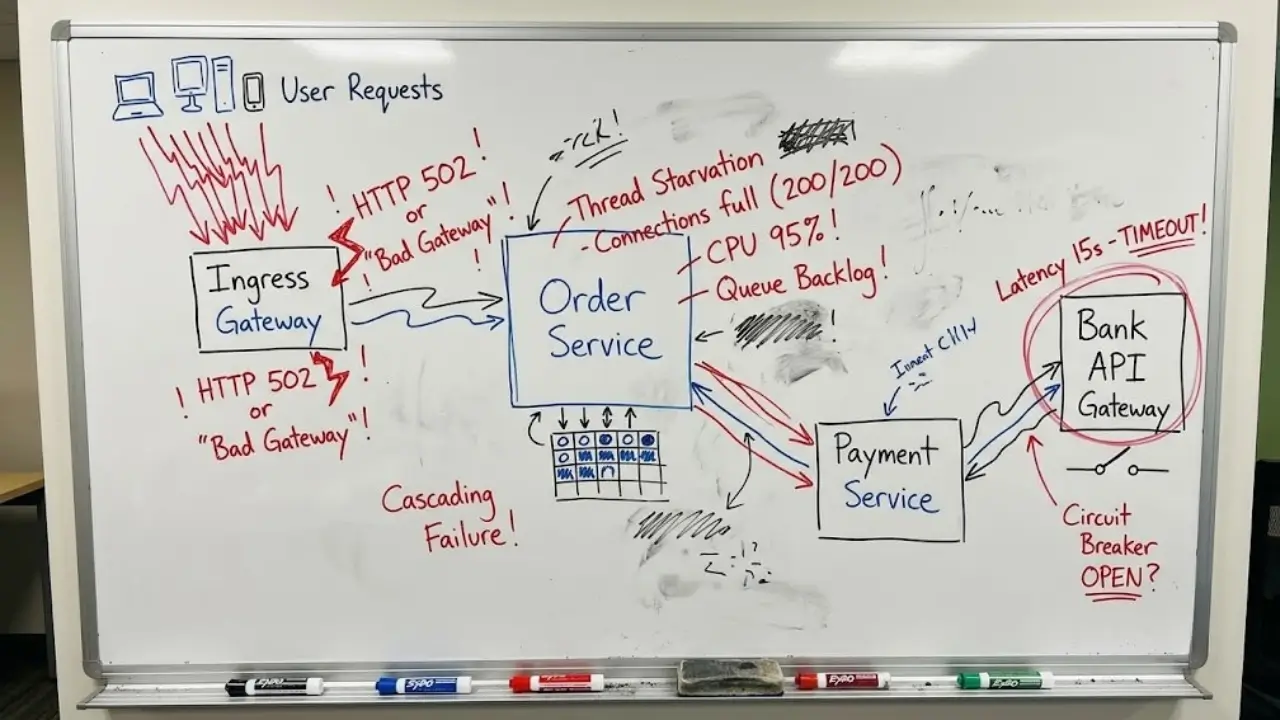
Gần đây team có gặp case sự cố ở Production, hệ thống bên mình là Ecommerce, nghĩ cũng có thể giúp được anh em chưa biết nên mình chia sẻ thực tế, đây là kinh nghiệm và công nghệ mà chỗ mình dùng nên mọi người xem xét để lấy mindset (chắc chắn là mình có đúc kết phía dưới).
Cũng vì thấy DevOps VietNam hoạt động vì sự phát triển của cộng đồng mang nhiều quyền lợi cho anh em kỹ sư và lan tỏa giá trị của doanh nghiệp nên mình cũng muốn góp chút công sức để có thể để lại kinh nghiệm thực tế lâu dài.
Bài toán lúc đó hệ thống lỗi HTTP 502 tăng đột biến thì một Software Engineer khi đối mặt là mở terminal, bật APM tool, dò từng dòng trace và tra log để tìm xem đoạn code nào vừa ném ra exception (hỏi dò biết thói quen của các ae SE trong team cũng hay như thế).
Trong môi trường phát triển (dev/staging), phản xạ này phản ánh nhanh nhạy và chuyên nghiệp, dễ hiểu là kỹ sư không chấp nhận giải pháp chắp vá, phải đào sâu đến tận root cause để bảo đảm tính toàn vẹn của mã nguồn.
Thế nhưng khi áp dụng nguyên vẹn phản xạ này vào môi trường Production đang gặp sự cố nghiêm trọng (severity 1) thì nó có thể trở thành một cách ứng cứu nguy hiểm.
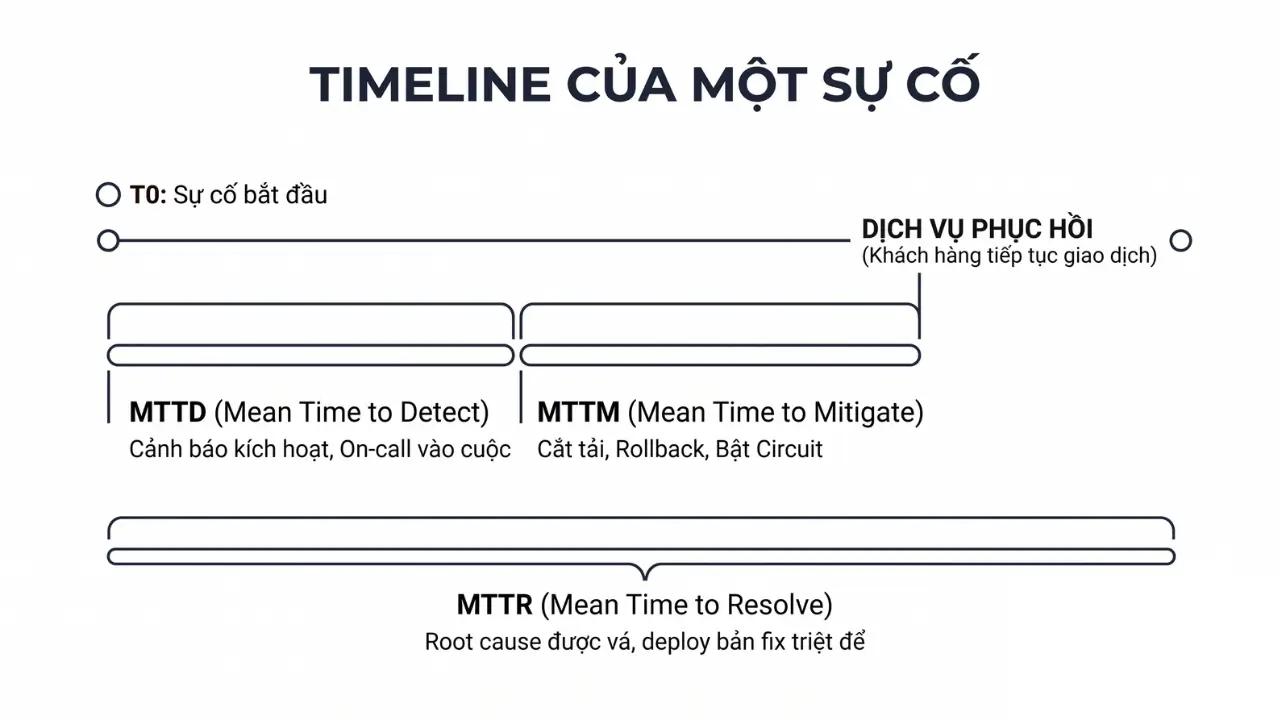
Theo mình thì trong quản trị vận hành, chỉ số sống còn đối với doanh nghiệp không phải là thời gian bạn tìm ra bug, mà là MTTM (Mean Time to Mitigate) thời gian tối thiểu để đưa hệ thống trở lại trạng thái phục vụ người dùng. Quá trình vá lỗi triệt để (MTTR – Mean Time to Resolve) hoàn toàn có thể thực hiện sau đó, khi “ngọn lửa” đã được dập tắt.
Case Study: Cascading Failure tại cổng thanh toán
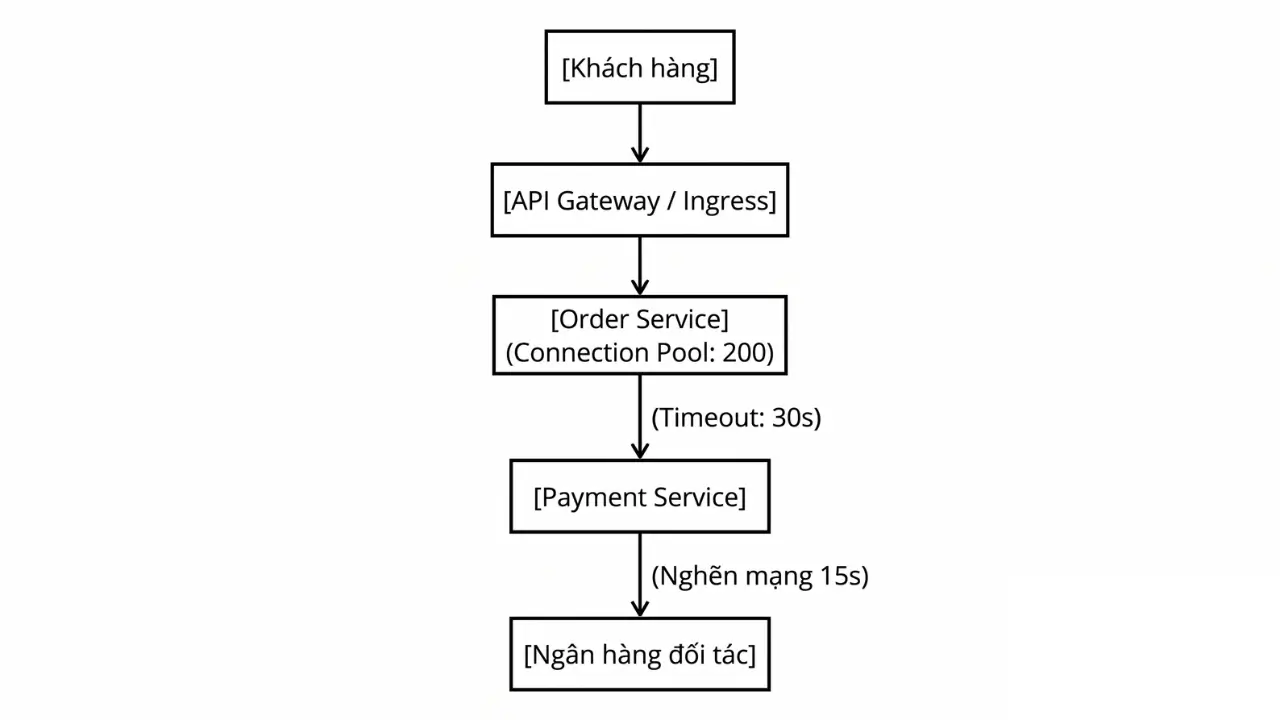
Mình phác thảo đơn giản kiến trúc phân tán thực tế bên mình là của một nền tảng Ecommerce: dịch vụ tiếp nhận đơn hàng (Order Service) giao tiếp qua HTTP/gRPC với cổng thanh toán nội bộ (Payment Service), trước khi ủy quyền giao dịch ra API của ngân hàng đối tác bên ngoài.
Cụ thể sự cố
Mình mô tả cụ thể nhưng cũng khoảng khoảng nhé con số cụ thể hơi đụng chạm chút:
- Hệ thống ngân hàng đối tác gặp sự cố định tuyến mạng, đẩy độ trễ phản hồi trung bình từ 120ms vọt lên 15.000ms (15 giây).
Order Serviceđược cấu hình HTTP connection pool với dung lượng tối đa 200 connections, giá trịread_timeoutmặc định là 30 giây.- Dưới lưu lượng 80 đơn hàng/giây trong giờ cao điểm, chỉ sau chưa đầy 3 giây, toàn bộ 200 connections của pool đều rơi vào trạng thái chờ I/O từ ngân hàng.
- Các worker thread bị giữ chặt, cache full,
Order ServiceThread Starvation. Nó không chỉ nghẽn luồng thanh toán mà còn từ chối xử lý cả các tác vụ nhẹ như xem chi tiết đơn, tra cứu lịch sử mua sắm. - Ingress Controller gửi health-check probe tới
Order Servicenhưng liên tục bị timeout quá 3 lần. Ingress tự động đánh dấu các container là Unhealthy và trả về mã lỗi HTTP 502/504 hàng loạt trên toàn bộ ứng dụng.
Đối chiếu hai cách xử lý trong War Room
Phần này là mindset xử lý và chắc chắn là mình không có nói đúng hay sai hoặc đánh giá vị trí nào nhé, mỗi người mỗi nhiệm vụ điều mình chỉ ra để anh em nào có nhu cầu sẽ hiểu biết về góc nhìn của vị trí kia hơn:
| Tiêu chí | Kỹ sư tư duy Debugger | Kỹ sư tư duy Incident Commander |
|---|---|---|
| Hành động tức thì | Mở Datadog APM, SSH vào server, soi từng dòng log exception, kiểm tra câu lệnh SQL xem có bị lock bảng hay không. | Đọc Dashboard, khoanh vùng phạm vi ảnh hưởng: cụm thanh toán đang kéo sập toàn bộ Order Service. |
| Phán đoán & Xử lý | Nghi ngờ timeout cấu hình quá cao hoặc rò rỉ bộ nhớ, mở source code, sửa lại tham số trong file .env, tạo Pull Request và chờ CI/CD build Docker image mới. |
Nhận diện đây là sự cố nghẽn I/O từ bên thứ ba. Lập tức thực thi kịch bản ứng cứu định sẵn: cô lập nguồn lỗi, bảo vệ luồng kinh doanh chính. |
| Thao tác can thiệp | Không dám can thiệp sâu vì sợ “code chạy không đúng logic ban đầu”. Đợi deploy bản vá mất 20-30 phút. | 1. Kích hoạt circuit breaker thủ công tới cổng ngân hàng lỗi. 2. Bật Feature Flag chuyển hướng thanh toán sang ví điện tử nội bộ hoặc COD. 3. Bật Rate Limiting tại Gateway để giảm áp lực lên cụm web. |
| Kết quả thực tế | Hệ thống sập diện rộng suốt 35 phút. Khách hàng phản hồi tiêu cực, thiệt hại doanh thu trực tiếp. | Dịch vụ chính phục hồi sau 3 phút. Chỉ có phương thức thanh toán qua ngân hàng lỗi bị tạm ngưng có chủ đích. |
Các mẫu kiến trúc phục vụ Chế độ sinh tồn
Tư duy giảm thiểu tác động không thể phát huy hiệu quả nếu hệ thống được xây dựng theo mô hình monolith, như vậy sẽ thiếu đi các “cầu dao an toàn”. Theo mình để có thể mitigation trong vài chục giây, hạ tầng cần tích hợp sẵn các mẫu thiết kế sau:
Circuit Breaker chủ động (Pattern ngắt mạch)
Không để tài nguyên nội bộ bị ngốn bởi sự chậm chạp của upstream/downstream. Một module circuit breaker chuẩn mực phải tự động ngắt kết nối khi tỷ lệ lỗi vượt ngưỡng cho phép, đồng thời trả về phản hồi dự phòng ngay tức thì:
// cấu hình Circuit Breaker với thư viện Sonyflake/Gobreaker (show code cụ thể đương nhiên không tiện, sample thôi nhé)
var cbSettings = gobreaker.Settings{
    Name:        "BankPaymentGateway",
    MaxRequests: 5,                   // Số request thử nghiệm khi ở trạng thái Half-Open
    Interval:    10 * time.Second,    // Chu kỳ xóa bộ đếm lỗi
    Timeout:     30 * time.Second,    // Thời gian giữ mạch hở (Open) trước khi chuyển Half-Open
    ReadyToTrip: func(counts gobreaker.Counts) bool {
        failureRatio := float64(counts.TotalFailures) / float64(counts.Requests)
        return counts.Requests >= 20 && failureRatio >= 0.5 // Mở mạch nếu lỗi >= 50% trên tối thiểu 20 requests
    },
}
Khi open state, hệ thống không gửi thêm bất kỳ request nào ra ngoài, release tức thì các worker thread đang bị stuck.
Load Shedding & Request Prioritization
Khi CPU của máy chủ vượt ngưỡng 85%, thay vì cố chấp xử lý mọi yêu cầu để rồi sập hoàn toàn do Out-Of-Memory (OOM), hệ thống cần chủ động từ chối phục vụ các luồng dữ liệu thứ cấp tại tầng API Gateway:
- Nhóm ưu tiên thấp (Drop ngay): thu thập telemetry, gợi ý sản phẩm cá nhân hóa, cập nhật lượt xem bài viết.
- Nhóm ưu tiên cao (Bảo vệ tối đa): xác thực tài khoản, trừ tiền giỏ hàng, ghi nhận trạng thái đơn hàng.
Chuyển đổi trạng thái graceful degradation
Một kiến trúc vững với mình phải có khả năng hoạt động ở nhiều trạng thái khác nhau thay vì chỉ có hai trạng thái: Chạy hoàn hảo hoặc Chết hoàn toàn.
Khi cụm cơ sở dữ liệu chính (master database) bị quá tải write I/O, hệ thống có thể chuyển sang chế độ read-only cache mode: cho phép người dùng xem sản phẩm từ dữ liệu cache của Redis/CDN, đồng thời hiển thị thông báo tạm ngưng tiếp nhận đơn hàng mới trong vài phút để DB hạ nhiệt.
Availability đối đầu Data Integrity
Mặc dù mục tiêu hàng đầu của Incident Response là phục hồi dịch vụ, có một ranh giới tuyệt đối không được phép bước qua: Tính toàn vẹn của dữ liệu (data integrity).
Giữa việc hệ thống tạm ngừng hoạt động (downtime) và việc hệ thống hoạt động sai lệch dữ liệu tài chính hoặc dữ liệu người dùng, hậu quả của việc sai dữ liệu luôn thảm khốc hơn gấp nhiều lần.
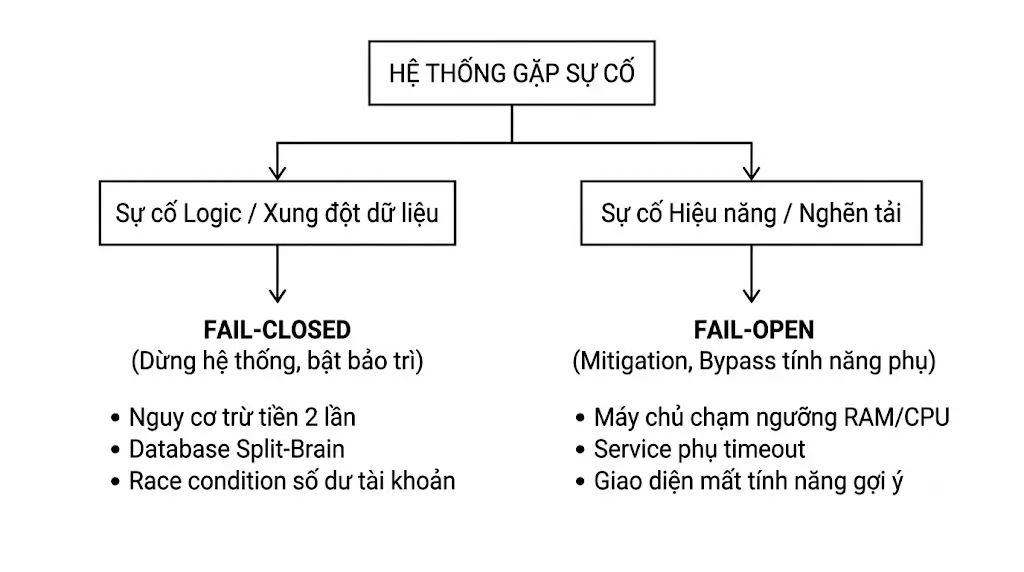
- Nguyên tắc Fail-Open: áp dụng khi lỗi chỉ liên quan đến trải nghiệm người dùng. Nếu hệ thống gợi ý sản phẩm sập, bypass nó và trả về danh sách sản phẩm bán chạy tĩnh. Nếu hệ thống kiểm tra avatar người dùng gặp lỗi, gán ảnh mặc định.
- Nguyên tắc Fail-Closed: áp dụng cho các luồng hạch toán tài sản, xác thực danh tính và ghi nhận giao dịch. Nếu phát hiện transaction database có dấu hiệu không bảo đảm tính nhất quán (ACID), xuất hiện race condition dẫn đến trừ tiền hai lần hoặc tạo số dư ảo: Lập tức bật trang bảo trì kỹ thuật (Maintenance Mode).
Downtime làm mất doanh thu trong một vài giờ, nhưng một cơ sở dữ liệu bị hỏng tính nhất quán có thể làm hỏng hẳn uy tín doanh nghiệp, kéo theo trách nhiệm pháp lý và rất nhiều thời gian đối soát thủ công trong bất lực.
Từ giải pháp tình thế đến kỷ luật Blameless Post-Mortem
Một giải pháp mitigation thành công nếu không được theo dõi chặt chẽ sẽ nhanh chóng biến thành một bãi rác nợ kỹ thuật (chính là Technical Debt ae chắc nghe nhiều rồi). Thiết lập một cronjob tự động restart service mỗi khi đầy RAM để cứu hệ thống trong đêm trực là sự nhạy bén của một On-call Engineer, nhưng để cronjob đó chạy âm thầm suốt vài tháng tiếp theo lại là sự vô trách nhiệm 😀
Để quy trình vận hành thực sự tốt thì mọi hành động can thiệp khẩn cấp phải tuân thủ chu trình khép kín, mình cũng chia sẻ luôn nhé cũng chẳng giấu gì.
1. Quy tắc Golden Ticket
Mọi can thiệp “nóng” trên Production (sửa biến môi trường thủ công, scale pod vượt mức trần ngân sách, tắt feature flag, vô hiệu hóa foreign key) đều bắt buộc phải đi kèm một Ticket có độ ưu tiên cao nhất (P0/P1) được sinh ra ngay sau khi đóng War Room.
2. Buổi họp Blameless Post-Mortem
Trong vòng 24 đến 48 giờ sau sự cố, toàn bộ các bên liên quan cần ngồi lại để thực hiện phân tích mổ xẻ sự cố không chỉ trích và đổ lỗi:
- Thiết lập mốc thời gian chi tiết từng phút: Sự cố xảy ra lúc nào? Cảnh báo reo lúc nào? Lệnh mitigation nào được kích hoạt?
- Áp dụng kỹ thuật 5 Whys để tìm ra nguyên nhân sâu xa từ kiến trúc hoặc quy trình kiểm thử, không quy trách nhiệm cá nhân cho người gõ lệnh deploy.
3. Đóng Incident đúng nghĩa
Một sự cố chỉ được xem là xử lý hoàn tất khi và chỉ khi:
- Bản vá lỗi triệt để đã được merge, kiểm thử hồi quy và triển khai an toàn lên Production.
- Toàn bộ các cấu hình can thiệp tạm thời (Feature Flag, rate limit khẩn cấp, cronjob restart) đã được dọn dẹp hoặc gỡ bỏ hoàn toàn.
- Các chỉ số cảnh báo (alert metrics) mới được bổ sung vào hệ thống giám sát để phát hiện sớm triệu chứng tương tự trước khi nó kịp bùng phát thành sự cố Severity 1.
Hết
Theo mình thì sự trưởng thành về mặt chuyên môn của một kỹ sư không chỉ đo bằng việc viết ra những đoạn mã phức tạp hay tối ưu thuật toán đến từng microsecond. Nó còn được thể hiện rõ nét nhất qua bản lĩnh trong phòng tác chiến: biết gác lại sự tự ái nghề nghiệp, tạm dừng việc soi từng dòng code, quyết đoán kéo chiếc “cầu dao khẩn cấp” để cứu vớt trạng thái khả dụng của hệ thống trước mắt người dùng.
Mình cũng rất recommend anh em muốn vận hành hạ tầng on-premise nên thi lấy cái CKA của CNCF sẽ thêm những kiến thức về mặt quản trị hạ tầng kubernetes, những bài chia sẻ và nguồn học thì trên website DevOps VietNam mình thấy cũng rất nhiều bạn chia sẻ rồi.